Un texte généré en quelques secondes, une image créée à partir d’une simple consigne, une réponse automatique envoyée à un client : l’intelligence artificielle s’est installée dans les usages courants sans toujours être clairement identifiée. Cette présence rapide nourrit autant l’enthousiasme que la méfiance, surtout lorsque la technologie intervient dans le travail, l’information ou les décisions qui concernent directement les personnes.
Les inquiétudes sont fondées, mais elles ne justifient pas forcément un rejet complet. L’IA peut accélérer certaines tâches et améliorer la productivité, à condition d’être utilisée avec des règles précises, des vérifications humaines et une attention constante portée aux données, aux droits et à la qualité des résultats.
Une technologie déjà présente dans la vie quotidienne
L’intelligence artificielle ne se limite pas aux assistants conversationnels apparus récemment. Elle intervient depuis plusieurs années dans les moteurs de recherche, les recommandations de vidéos, la détection des fraudes bancaires, la traduction automatique, la reconnaissance vocale et le filtrage des courriels indésirables.
La nouveauté tient surtout à la popularisation de l’IA générative. Ces systèmes peuvent produire du texte, du code, des images, de la musique ou des vidéos à partir d’une instruction formulée en langage naturel. Leur facilité d’accès donne l’impression qu’une machine comprend réellement une demande, alors qu’elle calcule surtout des résultats probables à partir de grandes quantités de données.
L’OCDE définit un système d’IA comme un dispositif capable, avec différents degrés d’autonomie, de déduire à partir de données des contenus, des recommandations, des prédictions ou des décisions susceptibles d’influencer un environnement physique ou virtuel. Cette définition rappelle que l’IA regroupe des outils très différents, dont les niveaux de fiabilité et les conséquences ne sont pas comparables.
La majorité des solutions disponibles aujourd’hui relèvent d’une IA spécialisée. Un logiciel peut être très performant pour classer des images ou générer une description de produit sans posséder pour autant une compréhension générale du monde, une conscience ou un jugement moral.
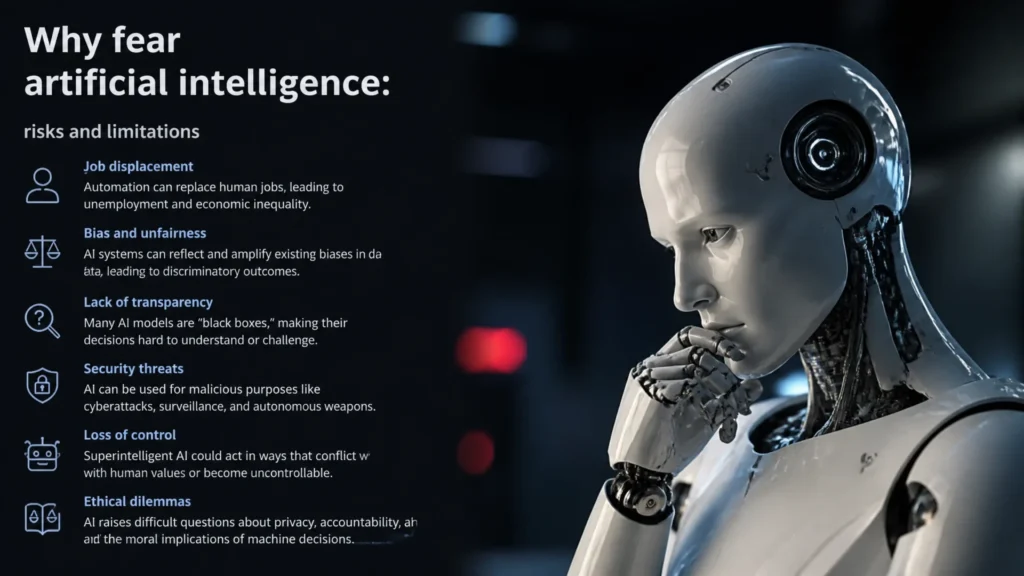
Les raisons concrètes de se méfier de l’IA
La transformation du travail
La crainte la plus répandue concerne l’emploi. Des tâches répétitives dans la rédaction, la traduction, le service client, l’analyse de documents ou le développement peuvent être automatisées en partie, ce qui modifie la valeur de certaines compétences et remet en question des organisations installées.
L’Organisation internationale du travail estime que l’IA générative touchera de nombreuses professions, mais que son effet le plus probable sera souvent une transformation des métiers plutôt qu’une disparition totale des postes. Un rédacteur, par exemple, peut produire plus rapidement un premier brouillon grâce à un outil, tout en restant indispensable pour définir l’angle, vérifier les faits, comprendre le public et engager sa responsabilité.
Le risque n’est donc pas uniquement de perdre un emploi. Il réside aussi dans la dévalorisation de certaines tâches, l’accélération excessive des rythmes, la surveillance des salariés ou l’apparition d’un écart entre les personnes formées à ces outils et celles qui en sont éloignées.
Des réponses plausibles, mais parfois fausses
Les systèmes génératifs peuvent produire une réponse fluide, précise en apparence et pourtant totalement erronée. Ils peuvent inventer une source, attribuer une citation à la mauvaise personne, confondre deux dates ou présenter une information ancienne comme si elle était toujours valable.
Ce phénomène, souvent appelé hallucination, devient particulièrement dangereux dans les domaines de la santé, du droit, de la finance et de l’actualité. Une erreur publiée sur un site professionnel peut entraîner une mauvaise décision, dégrader la réputation d’une entreprise ou exposer celle-ci à un risque juridique.
La diffusion massive de contenus automatisés pose également un problème de qualité. Si des milliers de pages sont produites sans expérience réelle, sans sources fiables et sans apport original, le web risque de se remplir de textes interchangeables qui répondent mal aux besoins des internautes.
Les biais présents dans les données
Une IA apprend à partir de données conçues ou collectées par des humains. Lorsque ces données contiennent des déséquilibres liés au genre, à l’origine, à l’âge, au handicap ou à la situation sociale, le système peut reproduire ces biais et parfois les amplifier.
Un outil de recrutement pourrait, par exemple, favoriser certains profils parce que les anciennes décisions de l’entreprise privilégiaient déjà ces profils. Un système publicitaire peut aussi montrer certaines offres d’emploi ou certains services à une partie de la population plutôt qu’à une autre, sans que cette sélection soit facilement visible.
La performance technique ne garantit donc pas l’équité. Une réponse rapide et statistiquement cohérente peut rester injuste si les critères utilisés sont incomplets ou si les résultats ne sont jamais contrôlés par une personne capable de repérer les discriminations.
La confidentialité des informations
Pour obtenir une réponse personnalisée, les utilisateurs transmettent parfois des informations sensibles à des services dont ils connaissent mal les conditions de fonctionnement. Un salarié peut copier un contrat, un fichier client, un rapport interne ou des données financières dans un outil public, sans mesurer les conséquences de cette action.
Une entreprise doit définir une politique claire avant de déployer une solution d’IA. Les équipes doivent savoir quelles informations peuvent être transmises, quels outils sont autorisés, comment les données sont conservées et qui peut accéder aux résultats produits.
Cette vigilance concerne aussi les sites web. Les données de navigation, les formulaires, les historiques d’achat et les échanges avec un chatbot peuvent révéler beaucoup d’informations sur les personnes. Leur collecte doit rester proportionnée, sécurisée et conforme aux obligations applicables, notamment en matière de protection des données personnelles.
La création et le droit d’auteur
Les contenus générés par IA soulèvent des interrogations sur l’origine des données ayant servi à entraîner les modèles. Un texte ou une image peut reprendre des éléments proches d’une œuvre existante, imiter fortement le style d’un créateur ou utiliser une ressemblance sans autorisation claire.
La question de la propriété du résultat final n’est pas toujours simple non plus. Les conditions d’utilisation varient selon les services, tandis que la législation évolue encore dans plusieurs pays. Une entreprise qui publie automatiquement des illustrations, des musiques ou des textes commerciaux doit donc vérifier les licences et conserver une trace de ses choix.
Des risques différents selon les usages
Il serait trompeur de parler de l’IA comme d’un bloc unique. Le niveau de danger dépend de la tâche confiée, de la sensibilité des données utilisées, de la possibilité de corriger une erreur et des conséquences pour les personnes concernées.
| Usage | Risque principal | Précaution utile |
|---|---|---|
| Rédaction SEO | Informations fausses ou contenu générique | Relecture, vérification des sources et ajout d’une expertise réelle |
| Analyse des visiteurs | Collecte excessive de données | Minimisation, anonymisation et contrôle des accès |
| Chatbot commercial | Réponse inadaptée ou promesse trompeuse | Transfert rapide vers un conseiller humain |
| Tri de candidatures | Biais et discrimination indirecte | Tests réguliers, critères explicites et décision humaine |
| Création d’images | Atteinte possible au droit d’auteur | Vérification des licences et des conditions du service |
La rédaction d’une fiche produit n’a pas les mêmes conséquences qu’une recommandation médicale. Dans le premier cas, une erreur peut être corrigée avant publication ; dans le second, elle peut influencer une décision concernant la santé d’une personne.
Faut-il renoncer à l’intelligence artificielle ?
Une interdiction générale serait difficile à appliquer et probablement contre-productive. De nombreux outils peuvent rendre des services réels lorsqu’ils interviennent sur des tâches à faible risque, comme la création d’un plan, la reformulation d’un passage, le classement d’informations ou la génération d’idées.
La bonne approche consiste à distinguer l’assistance de la délégation complète. Utiliser une IA pour préparer une analyse n’est pas la même chose que lui confier seule une décision qui engage la situation professionnelle, financière ou personnelle d’un individu.
Le cadre européen sur l’intelligence artificielle repose notamment sur une approche fondée sur les niveaux de risque. Certains usages sont interdits, tandis que les systèmes considérés comme à haut risque doivent respecter des exigences renforcées en matière de documentation, de qualité des données, de cybersécurité, de traçabilité et de supervision humaine.
Cette logique peut être transposée à une petite entreprise. Avant d’adopter un outil, il est utile d’identifier son objectif, les données utilisées, les erreurs possibles, la personne responsable du contrôle et la procédure prévue lorsqu’un résultat semble douteux.
Une méthode responsable pour les sites web
Sur un site orienté SEO, l’IA peut aider à organiser une recherche de mots-clés, repérer des questions fréquentes, comparer la structure de pages concurrentes ou préparer une première version de contenu. Elle ne devrait toutefois pas devenir une machine à publier sans ligne éditoriale, sans expertise et sans contrôle.
- Définir le rôle exact de l’outil avant chaque utilisation et préciser ce qui reste sous la responsabilité humaine.
- Ne jamais considérer une réponse comme automatiquement exacte, même si le style paraît assuré et professionnel.
- Vérifier les chiffres, les liens, les citations et les références avant toute publication ou décision.
- Écarter les données confidentielles et les informations personnelles des services non approuvés.
- Prévoir une validation spécialisée pour les sujets médicaux, juridiques, financiers ou sociaux.
- Mesurer la qualité réelle à partir de l’utilité, de l’exactitude, des conversions et des retours des utilisateurs.
Le cadre de gestion des risques proposé par le NIST s’appuie sur quatre fonctions : gouverner, cartographier, mesurer et gérer. Cette démarche invite les organisations à examiner la fiabilité, la sécurité, la transparence, l’explicabilité, la confidentialité et les biais, plutôt que de se limiter au nombre de contenus produits.
La transparence compte également dans la relation avec le public. Lorsqu’un internaute échange avec un chatbot ou consulte un contenu fortement automatisé, il doit pouvoir comprendre la nature du service auquel il a affaire, surtout si une décision ou une recommandation peut avoir des conséquences importantes.
Une vigilance qui dépasse la performance
La question environnementale mérite aussi d’être prise en compte. L’entraînement et l’utilisation de modèles puissants nécessitent des infrastructures informatiques, de l’électricité, des centres de données et des ressources matérielles dont l’impact n’est pas toujours visible pour l’utilisateur final.
Il faut également considérer les conséquences sociales : concentration du pouvoir entre quelques entreprises, dépendance à des services étrangers, fragilisation de certains métiers et accès inégal aux compétences numériques. Une innovation n’est pas automatiquement bénéfique parce qu’elle est rapide ou impressionnante.
Les recommandations de l’UNESCO insistent sur la protection des droits humains, l’égalité, la diversité culturelle, la responsabilité et la préservation de l’environnement. Ces principes peuvent guider les choix quotidiens d’une entreprise, même lorsqu’elle ne dispose pas d’une équipe juridique ou technique spécialisée.
La peur de l’IA traduit souvent une crainte plus large : celle de ne plus savoir qui décide, qui contrôle les données et qui répond d’une erreur. La confiance ne peut donc pas reposer uniquement sur la promesse d’un outil ; elle doit s’appuyer sur des règles compréhensibles, des contrôles réels et la possibilité de faire intervenir un humain.
Garder la main sur les choix décisifs
Craindre l’intelligence artificielle est légitime lorsqu’elle menace l’emploi, la vie privée, l’équité ou la fiabilité de l’information. Ces risques ne commandent pourtant pas de refuser toute technologie, mais d’en limiter les usages selon leurs conséquences.
L’IA peut assister, accélérer et inspirer, sans remplacer systématiquement le jugement humain. La meilleure protection reste une utilisation mesurée, transparente et vérifiée, dans laquelle la responsabilité finale demeure clairement attribuée à une personne ou à une organisation.
Pour les sites web comme pour les autres activités, la question essentielle n’est donc pas de savoir s’il faut avoir peur de l’IA, mais jusqu’où lui faire confiance et dans quelles conditions l’utiliser.
Références pour approfondir
Les repères institutionnels utilisés pour encadrer ces pratiques sont notamment le cadre de l’OCDE sur les systèmes d’intelligence artificielle, l’étude de l’Organisation internationale du travail sur l’IA générative et l’emploi, ainsi que le cadre de gestion des risques du NIST.
La recommandation de l’UNESCO sur l’éthique de l’intelligence artificielle apporte également des repères sur les droits humains, l’environnement et l’égalité. Pour les obligations applicables en Europe, la Commission européenne présente le cadre réglementaire de l’IA et les règles de transparence associées à certains systèmes.
FAQ
L’intelligence artificielle inquiète parce qu’elle peut transformer l’emploi, produire des informations fausses, reproduire des biais, exposer des données sensibles et influencer des décisions importantes sans contrôle humain suffisant.
Elle peut automatiser certaines tâches dans la rédaction, la traduction, le service client, l’analyse documentaire ou le développement, mais son effet le plus probable reste souvent une transformation des métiers.
Les systèmes génératifs produisent des réponses probables à partir de données et peuvent donc inventer des sources, confondre des dates, attribuer une citation à la mauvaise personne ou utiliser des informations dépassées.
Oui, une IA peut reproduire ou amplifier des discriminations lorsque les données d’entraînement reflètent des inégalités liées au genre, à l’origine, à l’âge, au handicap ou à la situation sociale.
Une organisation doit limiter les informations transmises, interdire les données confidentielles dans les services non approuvés, contrôler les accès et définir des règles sur la conservation et l’utilisation des résultats.
Une interdiction générale serait difficile à appliquer et probablement contre-productive, car l’IA peut aider pour des tâches à faible risque, à condition que ses résultats soient vérifiés et que les décisions importantes restent humaines.