L’intelligence artificielle est passée des laboratoires de recherche aux outils du quotidien. Elle recommande un film, repère une anomalie sur une image médicale, traduit une phrase ou aide un véhicule à anticiper un danger, sans pour autant penser comme un être humain.
Son histoire commence bien avant les assistants conversationnels et les modèles génératifs. Elle repose sur plusieurs décennies de recherches en mathématiques, en informatique et en sciences cognitives, avec une question centrale : jusqu’où une machine peut-elle reproduire certaines capacités humaines ?
La naissance d’une idée scientifique
Avant que l’expression « intelligence artificielle » ne soit officiellement employée, des chercheurs s’interrogeaient déjà sur la possibilité de faire exécuter à une machine des opérations associées au raisonnement. Les premiers ordinateurs, apparus au milieu du XXe siècle, étaient encore très limités, mais leur capacité à manipuler rapidement des symboles ouvrait une perspective nouvelle.
En 1950, le mathématicien britannique Alan Turing publie un article devenu célèbre, dans lequel il pose la question suivante : une machine peut-elle penser ? Plutôt que de définir précisément la pensée, il propose un dispositif appelé plus tard test de Turing, fondé sur la capacité d’un ordinateur à soutenir une conversation suffisamment convaincante pour être confondu avec un humain.
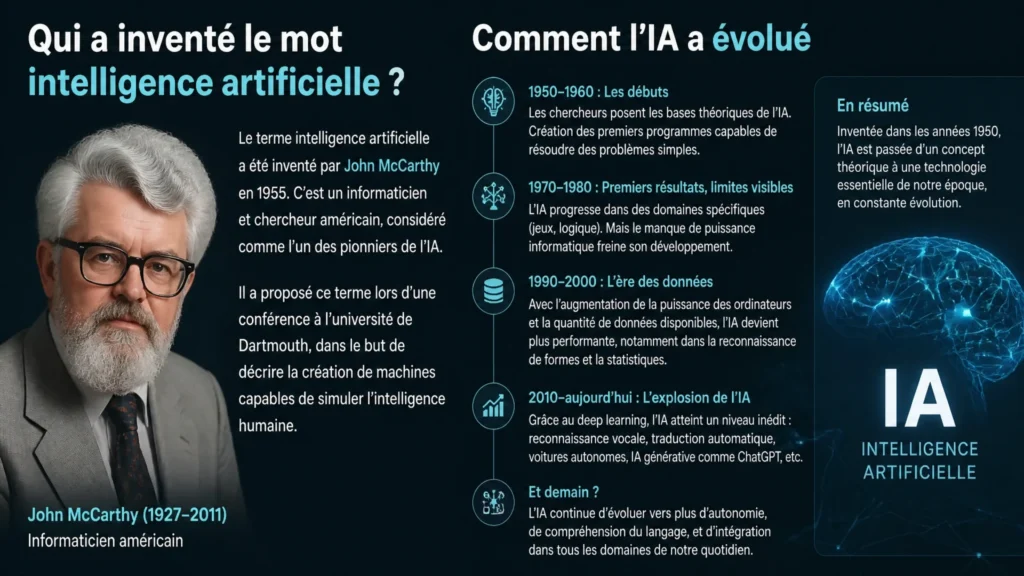
Le terme intelligence artificielle est attribué à l’informaticien américain John McCarthy. Il apparaît dans le projet de recherche préparant la conférence de Dartmouth, organisée en 1956 aux États-Unis avec Marvin Minsky, Nathaniel Rochester et Claude Shannon, puis devient le nom d’un nouveau champ scientifique.
La conférence de Dartmouth ne crée pas à elle seule toutes les techniques de l’IA, mais elle donne un nom, un programme de recherche et une ambition commune à des travaux jusque-là dispersés.
Les participants pensent alors que des progrès importants peuvent être réalisés rapidement. Leur optimisme est compréhensible : les premiers programmes sont capables de résoudre des problèmes logiques, de manipuler des symboles et de démontrer certains théorèmes mathématiques, même si leurs performances restent très éloignées de l’intelligence générale humaine.
Les chercheurs qui ont marqué les débuts
John McCarthy joue un rôle déterminant dans la structuration du domaine. Il crée également le langage de programmation LISP, longtemps utilisé dans les laboratoires d’IA pour sa souplesse et sa capacité à traiter des structures symboliques.
Marvin Minsky, cofondateur du laboratoire d’intelligence artificielle du MIT, travaille sur la perception, la robotique et la représentation des connaissances. Il défend l’idée que l’intelligence pourrait être décomposée en une série de fonctions élémentaires, comme la mémoire, la reconnaissance des formes ou le raisonnement.
De leur côté, Allen Newell et Herbert Simon développent le Logic Theorist, un programme capable de démontrer certains théorèmes. Cette réalisation montre qu’un ordinateur peut suivre des règles formelles et produire une solution dans un domaine précis, à condition que le problème soit correctement décrit.
Cette première période privilégie l’IA symbolique. Les chercheurs écrivent des règles explicites afin de représenter des faits et de déduire de nouvelles informations, une méthode efficace dans des environnements organisés, mais moins adaptée aux situations ambiguës, imprévisibles ou riches en données.
Des règles aux réseaux neuronaux
À partir des années 1980, les systèmes experts connaissent un certain succès dans des domaines spécialisés. Ils utilisent des bases de connaissances et des règles conçues avec l’aide de professionnels, par exemple pour assister un diagnostic technique ou médical, mais leur entretien devient vite coûteux lorsque les situations se multiplient.
Une autre approche gagne progressivement du terrain : l’apprentissage automatique. Au lieu de programmer chaque règle, on fournit à l’algorithme des exemples afin qu’il repère lui-même des régularités et améliore ses résultats selon les données disponibles.
Le développement du deep learning, ou apprentissage profond, accélère cette évolution. Les réseaux neuronaux comportent plusieurs couches de calcul capables d’extraire progressivement des caractéristiques dans une image, un son ou un texte, avec des performances favorisées par l’augmentation de la puissance informatique et des volumes de données.
Geoffrey Hinton, Yann LeCun et Yoshua Bengio comptent parmi les chercheurs les plus associés à cette renaissance des réseaux neuronaux. Leurs travaux contribuent à améliorer la reconnaissance d’images, la compréhension automatique du langage et la traduction, même si ces systèmes restent dépendants de la qualité de leur entraînement.
| Période | Évolution | Limite principale |
|---|---|---|
| 1950 | Proposition du test de Turing | La conversation ne mesure pas toutes les formes d’intelligence |
| 1956 | Formalisation du terme intelligence artificielle | Des attentes souvent plus rapides que les progrès réels |
| Années 1980 | Développement des systèmes experts | Maintenance complexe des règles et des connaissances |
| Depuis les années 2010 | Essor de l’apprentissage profond | Forte dépendance aux données et aux ressources de calcul |
Une présence dans de nombreux secteurs
L’IA n’est pas une technologie unique, mais un ensemble de méthodes adaptées à des tâches précises. Elle peut classer des informations, prévoir un résultat, détecter une anomalie, générer du contenu ou aider une personne à prendre une décision, sans disposer pour autant d’une compréhension comparable à celle d’un humain.
- Santé : analyse d’images radiologiques, aide à la recherche pharmaceutique, suivi de patients et repérage de facteurs de risque.
- Finance : détection de transactions inhabituelles, évaluation de risques, automatisation de certaines opérations et surveillance contre la fraude.
- Transport : assistance au maintien dans la voie, freinage d’urgence, optimisation des itinéraires et gestion des flux de circulation.
- Éducation : exercices adaptés au niveau d’un élève, correction assistée et repérage plus rapide des difficultés d’apprentissage.
- Industrie : maintenance prédictive, contrôle qualité par caméra et optimisation de la consommation énergétique.
- Culture et commerce : recommandations personnalisées, génération d’images ou de textes et analyse des préférences des utilisateurs.
Dans le domaine médical, par exemple, un logiciel peut comparer une image à des milliers de cas déjà analysés et signaler une zone suspecte. Il ne remplace pas automatiquement le professionnel de santé : le contexte clinique, l’examen du patient et la responsabilité de la décision restent essentiels.
Dans une entreprise, l’IA peut aussi traiter des demandes répétitives afin de laisser davantage de temps aux équipes pour les tâches complexes. Cette transformation ne signifie pas nécessairement la disparition d’un métier entier, mais elle modifie souvent la répartition des activités et les compétences attendues.
Les limites et les risques à prendre au sérieux
Un système d’IA apprend à partir de données qui peuvent être incomplètes, anciennes ou déséquilibrées. Si les exemples utilisés pour l’entraînement contiennent des discriminations, le modèle risque de les reproduire, voire de les amplifier, même lorsque son fonctionnement semble techniquement performant.
La protection des données personnelles constitue un autre enjeu majeur. Les informations utilisées pour entraîner ou faire fonctionner un outil doivent être collectées légalement, sécurisées et conservées pendant une durée justifiée, particulièrement lorsqu’il s’agit de données de santé, de données financières ou d’informations concernant des mineurs.
La question de la responsabilité devient délicate lorsqu’une décision automatisée cause un dommage. Un algorithme ne peut pas être tenu responsable comme une personne morale ou physique : il faut donc déterminer le rôle du concepteur, du fournisseur, de l’organisation utilisatrice et du professionnel qui valide le résultat.
Les modèles les plus complexes sont parfois qualifiés de boîtes noires, car leurs résultats sont difficiles à expliquer dans le détail. Or une personne refusée pour un crédit, un candidat écarté d’un recrutement ou un patient classé comme prioritaire doit pouvoir comprendre les raisons générales d’une décision qui l’affecte.
L’impact sur l’emploi mérite également une analyse nuancée. Les tâches répétitives sont les plus exposées à l’automatisation, tandis que de nouvelles fonctions apparaissent dans la supervision, la qualité des données, la cybersécurité et la conception de systèmes responsables.
- Former les salariés pour qu’ils puissent utiliser, contrôler et questionner les outils automatisés.
- Conserver une validation humaine pour les décisions sensibles ou irréversibles.
- Tester les modèles sur des situations variées afin de repérer les erreurs et les biais.
- Informer clairement les utilisateurs lorsqu’ils interagissent avec un système automatisé.
Des usages à encadrer avec discernement
Les progrès de l’IA offrent des perspectives importantes, notamment dans la médecine personnalisée, la découverte scientifique, l’accessibilité numérique et la transition énergétique. Ils ne garantissent toutefois ni la justesse des résultats ni leur utilité sociale : une technologie puissante peut produire de mauvaises réponses lorsqu’elle est mal conçue ou employée sans contrôle.
Un développement durable de l’IA suppose donc des règles de transparence, des audits indépendants et une attention constante aux droits fondamentaux. L’objectif n’est pas de donner une apparence humaine aux machines, mais de construire des outils fiables, compréhensibles et placés sous une responsabilité clairement définie.
L’expression inventée par John McCarthy en 1956 désigne aujourd’hui un domaine vaste, nourri par les travaux de plusieurs générations de chercheurs. L’IA transforme déjà la santé, l’industrie, les transports et les services, tout en posant des questions sur les biais, l’emploi et la vie privée. Son avenir dépendra moins de la seule performance des algorithmes que de la manière dont la société choisira de les concevoir, de les encadrer et de les utiliser.
FAQ
Le terme intelligence artificielle est généralement attribué à l’informaticien américain John McCarthy, qui l’a utilisé dans le projet préparant la conférence de Dartmouth organisée en 1956.
L’expression apparaît au milieu des années 1950, notamment dans une proposition de recherche liée à Dartmouth, avant de désigner officiellement un nouveau domaine scientifique lors de la conférence de 1956.
John McCarthy a contribué à structurer l’intelligence artificielle comme champ de recherche, a participé au projet de Dartmouth et a créé le langage de programmation LISP.
Alan Turing n’a pas inventé le terme intelligence artificielle, mais ses travaux ont profondément influencé le domaine, notamment son article de 1950 et la proposition du test évaluant une conversation homme-machine.
Marvin Minsky, Nathaniel Rochester, Claude Shannon, Allen Newell et Herbert Simon figurent parmi les pionniers, avec des travaux portant sur la robotique, les systèmes symboliques et la démonstration automatique.